Was ist KI?
Auf dieser Seite wird (generative) KI erklärt. Eine Übersicht der Tools, die die Uni Osnabrück anbietet, findet sich auf der Seite KI@UOS.
Generative KI ist ein Teil von Künstlicher Intelligenz. Der Begriff KI umfasst beispielsweise auch Algorithmen, die Gesichter erkennen oder Wetterprognosen erstellen. KI wird seit einigen Jahren vor allem dazu eingesetzt, Muster in große Datenmengen zu erkennen, z.B. in welcher Kombination bestimmte Faktoren zusammen mit einem spezifischen Wetterereignis aufgetreten sind, sodass sich Ableitungen für die Zukunft aufstellen lassen. Andere KI-Algorithmen haben im Training errechnet, welche Attribute in Abbildungen zwei verschiedene Arten von Objekten unterscheiden lassen. So kann ein Smartphone beispielsweise bestimmte Merkmale in Gesichtern mit dem Gesicht des Nutzenden vergleichen und das Gerät entsprechend entsperren.
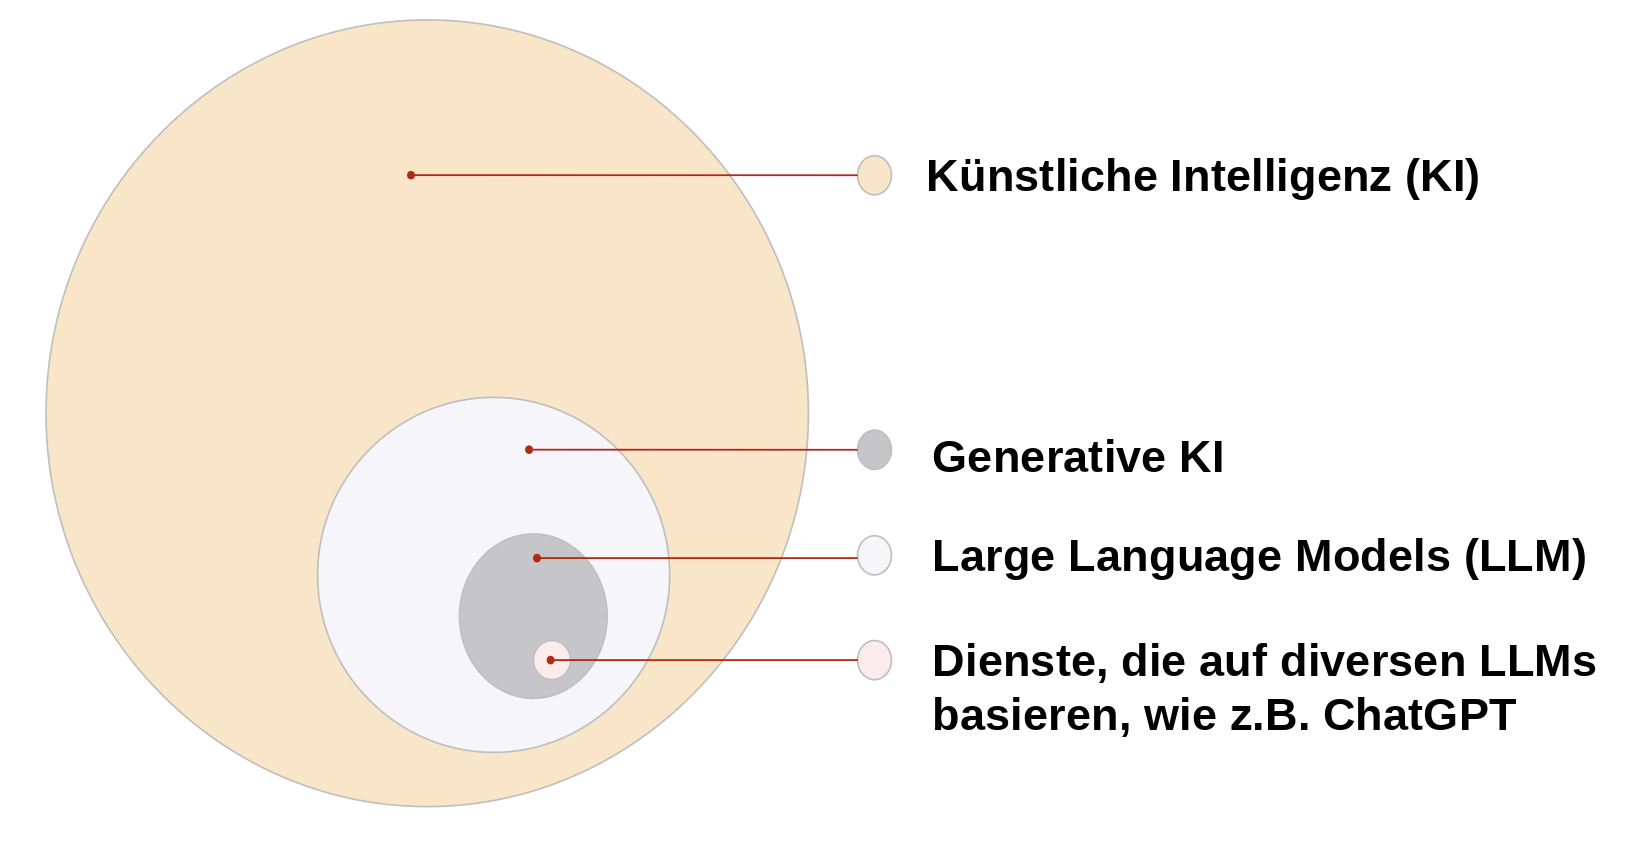
Es gibt also nicht „die KI“, sondern viele, teils sehr unterschiedliche Algorithmen, die für verschiedene Aufgaben programmiert wurden. Sie haben gemeinsam, dass sie mit einem Datensatz trainiert wurden, aus dem der Algorithmus Muster erkennt und Regeln ableitet. So ist es dem Algorithmus möglich, neue Daten zu klassifizieren – ohne den Input eine*r Programmierer*in.
Wir fokussieren uns hier auf die generative KI und im Speziellen auf Large Language Models (vergleiche Abbildung oben), weil sie neue Implikationen für die Lehre und das Lernen in allen Fächern mit sich bringt und für alle prinzipiell frei zugänglich und nutzbar ist. Large Language Models (LLMs) werden von Diensten wie kiwi, ChatGPT oder Gemini genutzt, um Sprache zu generieren. Es gibt auch generative KI Algorithmen, die Bilder oder Videomaterial erstellen können, sowie multimodale Modelle, die diese Eigenschaften miteinander kombinieren.
Eine Übersicht von verschiedenen generativen KI-Tools finden Sie auf den Lehrpfade-Seiten der TH Köln.
Wie werden LLMs trainiert?
Damit ein LLM einen Output generieren kann, der der menschlichen Sprachnutzung sehr ähnlich ist und Informationen über die Welt enthält, ist eine möglichst große Datenmenge an natürlicher Sprache notwendig. Entsprechend werden LLMs mit verschiedensten im Internet zugänglichen Sprachdaten trainiert; also mit geschriebenen Texten auf Webseiten, Tonspuren aus Videos, Audioaufnahmen aus Podcasts und Hörbüchern. KI-Anbieter verwenden jedoch auch KI-Chatverläufe der Nutzenden zum Training ihrer Anwendungen. Die gesammelten Daten werden zum Training der Algorithmen verwendet, ohne dass eine Klassifizierung von Sprachgebrauch oder inhaltlicher Richtigkeit erfolgt. Die Annahme ist, dass das durch eine genügend große Datenmenge kompensiert wird.
Wie funktionieren LLMs?
In diesem Video wird in 4 Minuten knapp erklärt, wie LLMs funktionieren.